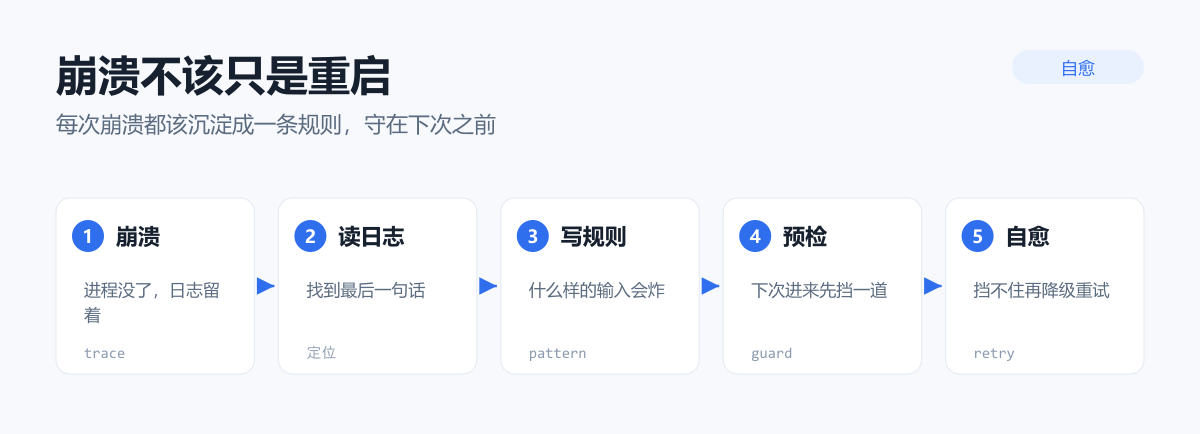
这条链长什么样
崩溃日志(黑匣子)
   ↓ 归因
条目(fingerprint 归并,记每次发生时间)
   ↓ 沉淀
规则(lore,精简到一句话)
   ↓
├─ 每次会话注入提示词(预防)
├─ 导出到 dsh-lite-memory(跨会话记忆)
├─ 装插件前静态预检(拦截)
└─ 起不来时停用元凶(自愈,需手动/循环确认)关键是最后那四条用法。光收集日志没用,能挡在下次之前才有用。
规则都是什么
作者列出来的判据很具体,不是「注意代码质量」这种废话,而是「已经证明会让本机崩溃的形态」:
| 编号 | 规则 |
|---|---|
| P014 / P015 | 模块顶层 throw / 裸 await |
| P016 | ESM 里 require |
| P017 | __dirname / __filename |
| P018 | 插件调 process.exit |
| P019 | 接管 SIGINT / SIGTERM |
| P009 | patch 重复 id |
| P010 | patch 引用的包没声明 |
| P001/P002/P005/P007/P008 | 包结构缺失 |
| P013 | node --check 语法闸 |
| P021 | tools.register 没闭合 |
看一眼就知道这些是真踩过的坑,不是拍脑袋想的。
比如 P018 插件调 process.exit——插件进程和宿主是同一个。插件里一句 process.exit(1),杀掉的是整个宿主,所有会话一起掉线。这个错误特别容易犯,因为「出错了就退出」是写脚本的肌肉记忆。
比如 P016 ESM 里 require——不是语法错误,是运行时才炸,而且往往只在你走到那个分支时才炸。
比如 P017 __dirname——ESM 里根本不存在这个变量,node --check 也过得了,运行到那行才 undefined。
这些规则的共同点:静态能看出来,运行时才致命。所以适合做预检。
两层防护:装之前和写之前
预检是装之前问一次,防护是在副作用发生之前每步都问:这次调用会不会让正在跑的宿主起不来。
| 层 | 宿主机制 | 管什么 |
|---|---|---|
| 写前守卫 | ctx.tools.guard()(同步,不可被放宽) |
write / edit 把写入后的完整文本交给规则检查;bash 只拦对 live 插件目录的整体删除/移动 |
| 安装前预检 | tools/pre-execute(异步 waterfall) |
plugin_manager 的 install_bundle / set_plugin(enabled):先解析候选目录、跑完整 preflight,再决定是否执行 |
两个细节值得注意:
写前守卫检查的是「写入后的完整文本」,不是 diff。 因为 diff 看不出「这段代码现在整体构成了一个顶层 throw」。
它同步、不可被放宽。 这意味着插件自己也没法绕过它。
live 面 = profile 目录本身 + profile 里所有插件源码,包括 link: 的开发树。为什么要算开发树?因为宿主就是通过软链加载它的——你改开发目录和改 live 目录,效果一样。
被拦下时长什么样
这个错误信息是我见过写得最完整的之一:
[LIFEGUARD_BLOCKED] 本次操作未执行。

插件:dsh-inner-browser-use
位置:/…/dsh-inner-browser-use/index.js:312
规则:P018 插件调用了 process.exit
原因:插件进程里调 process.exit 会直接杀掉宿主,所有会话一起掉线
证据:process.exit(1);
风险:这一步会在 running profile 里生效,宿主激活/热重载时崩溃,当前所有会话一起掉线。
建议:改成抛给 ctx 报错或返回失败结果,让加载器决定是否停用
改好后重新提交这次写入;你仍可以继续读代码、改开发副本、跑测试。
七行:拦了什么、在哪、哪条规则、为什么、证据、风险、怎么改。
而且最后一句很重要:你仍可以继续读代码、改开发副本、跑测试。它拦的是「在 live 面上生效」,不是「你不许动这个文件」。
这个区分决定了它能不能用。如果连改都不让改,那就是个绊脚石。
被拦的会话能继续工作,这是它最核心的体验设计:
拒绝时返回给发起调用的那个会话(不另开修复会话、不广播、不停用开发中的插件)。
放行什么
这一节比拦截规则更重要。一个只会拦的工具没人用。
放行:
- 读文件、看日志、搜索
- 改不相关项目
- 改开发副本
- 跑测试
- live 插件里正常的改动(加函数、改文案、调参数)
原则写得很清楚:宁可漏拦,也不拦正常开发。
静态守卫只在低误报的写法上开。createRequire() 不报,函数体里被 try/catch 兜住的 throw 不报。
化龙妙法:大会话转世
这一节是我最想单独讲的部分,因为它解决的是agent 长期使用中最真实的一个瓶颈。
作者的原话:
会话越长,恢复越贵——一个大会话恢复时要几 GB 堆,本机就是这么崩的。
这个我深有体会。我在一台手机上跑长期的 agent 会话,单轮价格随上下文线性涨,从 1MB 的 0.12 元涨到 3.4MB 的 0.33 元;到 3.4MB 时请求直接挂起——followup 有、turn/end 不来、CPU 0%、连接还在但没有数据。最后只能停掉、备份、把会话文件清空、重启。
根因就是「会话只增不减」。
转世的思路不是解救旧会话,而是把活交给一个新会话:
- 读原会话记录
- 写一份交接单
- 建新会话
- 把旧会话归档(不删,可取消归档回看)
交接单给了七节模板:目标 / 结论 / 走不通的路 / 改动 / 未完成与下一步 / 风险与注意。
作者特别点出最值钱的是哪一节:
最值钱的是「走不通的路」——新会话不用把失败方案再踩一遍。
这句说到根子上了。常规的「总结一下」只会记下做成了什么;真正省时间的是「试过 A 不行、B 不行,因为……」。
七条硬约束
转世这个动作本身很危险——它要在内存快满的时候读一份大会话。所以作者定了七条:
- 先量内存再读记录:堆到墙的 90% 就直接拒绝转世并说清改法,不让「读记录」这一步把宿主带走
- 只调一次模型,输入有字节上限、输出有字数上限、整次调用有超时;原会话再长也只留最近记录,但最早那条需求单独保住
- 堆到 85% 就不调模型了,直接退回自动摘要(只摘记录,不做判断)
- 交接单先写盘、回读确认字节数,再去通知新会话——发消息成功但磁盘上没有,重启后等于没交接
- 模型报错、超时、返回空、非正常收尾,一律退回自动摘要——转世不会因为整理失败而失败
- 交接单末尾固定让新会话先只回「收到」,免得一转世就当场再开重活,把刚空出来的内存立刻填回去
- 挂进工作区要回读:
attachSession落盘之后,成员列表还要过一遍启动时建的 cwd 索引,索引里没有的新会话会被静默滤掉
第 2 条那个「最早那条需求单独保住」,是一个非常懂行的细节。摘要总是偏向最近的对话,但最早的那句话说清了整件事要干什么。
第 6 条也很妙。转世的目的是释放内存,如果新会话一接手就开跑大任务,那这口气又喘不上来。
批量转世
会话多的时候不用一个个转:all: true 先列清单,默认什么都不动,只给前 5 个;确认后带 dryRun: false 再跑。
只挑已经停下、还没归档、又不是当前会话的那些。跑着的会话转世会被腰斩,跳过不劝。一次最多 5 个,顺序执行不并发,每个之前先看内存,到 92% 就收手。
批量默认走自动摘要——因为每个会话都让模型读一遍,token 和堆一起涨。想要判断力,单独给那个会话传 sessionId。
先演练
内存还宽裕的时候可以演练:
dryRun: true只读一次原会话,把交接单写到 $DSH_HOME/lifeguard/handoff/preview-<会话>.md,不建新会话、不动原会话,可反复跑。
作者的建议很实在:真正的交接成本不该全部压在墙边那一分钟里。趁内存还宽裕先把单子写出来,真要退出时直接接着干。
底部那个内存圈
输入框下方常驻一个 16px 的圈和占用率:
- 平时暗色环
- 越过 70% 转琥珀
- 越过 85% 转红并写一个感叹号
- 100% 是这台机器真正会死的堆,不是 V8 名义上限
为什么是「真正会死的」?因为崩溃日志记下的致命堆只在它仍然贴着当前运行时上限时才算数(同一次运行时下约 4.1 GB)。换过运行时、或没有崩溃记录,就退回「当前上限 × 85%」。
这条设计最狠的地方是每个用户按自己的日志校准:有崩溃记录就用你最高的一次致命堆当满阈值;没有就先按上限 × 85% 顶替;等真的崩过一次,下一次采样自动换成你自己的数字。
不需要谁去调参数。
还有个诚实到少见的设计:读不到数据时它不消失,淡成「内存 –」。理由写得很清楚——会消失的指示器分不出「内存没事」和「指示器坏了」。
临时快照:吃掉 58 GB 的那件事
崩溃排查会把会话快照复制到系统临时目录,一份几十到几百 MB。
作者写了一个具体数字:本机真到过 58 GB,磁盘只剩 42 GB。
现在的处理:启动时清一次、之后每 30 分钟清一次;删掉超过 6 小时的和超预算的,从最老的删起,刚建出来十分钟内的不删。默认预算 5 GB,可调(256–102400 MB)和保留期(1–168 小时)。
只认自己造的前缀(lifeguard-sessions-*、crash-lore-sessions-*),别的文件一个不碰。
这个边界划得很谨慎。清理脚本最容易犯的错就是「顺手把 tmp 也清了」,然后清掉别人正在用的东西。
一个特殊崩溃:起不来但日志里没插件
现象:重启后界面是空的,崩溃日志里是
DesktopHostFatalError: cannot create effect on inactive context栈在 cordis 的 Fiber._reload 与宿主 desktop 包的插件回调上。
成因在宿主侧:上一次宿主是崩掉的,恢复时它会把插件配置重新应用一遍,而那次配置打在一个已经失效的 fiber 上。插件代码改不动这条路径。
处置:⌘Q 退干净再开一次;同一个元凶 24 小时内反复出现,用 lifeguard_heal 停用它再起(改动前会备份,可 doctor --restore 撤销)。
「自我阻止」到底是什么意思
作者自己把话说得很克制:
「自我阻止」不是拦截每一次崩溃,而是同一形态的崩溃不会连续发生第二次——代价是有一次手动执行的 doctor/heal。
这句话值得抄在本子上。任何号称「防崩」的工具,如果暗示自己能拦住所有崩溃,那是在骗你。真正做得到的只有一件事:同样的坑不踩第二遍。
CLI
宿主起不来的时候,这些命令不依赖 DSH 进程:
node cli.mjs status                 # 规则/条目/已扫日志数
node cli.mjs scan                   # 扫描新日志并归因
node cli.mjs rules                  # 规则清单
node cli.mjs prompt --chars 900     # 注入的那段正文
node cli.mjs check <插件目录>        # 装机前预检,命中即 exit 1
node cli.mjs export                 # 只打印清单
node cli.mjs export --memory        # 写进长期记忆 global 层(会进召回,慎用)
node cli.mjs doctor                 # 只看计划
node cli.mjs doctor --yes           # 停用元凶(先备份,可 restore)
node cli.mjs doctor --auto          # 只在确认崩溃循环(24h 同元凶 ≥3 次)时停用
node cli.mjs restore <包名>          # 撤销停用
doctor 只改 profile 的 package.json 与 cordis.patch.yml 里对应那一行,改前 *.bak-<ts> 备份;解析失败就放弃,不留半写状态。
停用可撤销这条很重要。自动改配置的工具,如果不能撤销,就是危险品。
数据在哪
默认 $DSH_HOME/lifeguard/:
incidents.jsonl— 以 fingerprint 归并的崩溃条目,occurrenceTimes保留每次发生的时间,count是真实次数rules.json— 规则库state.json— 已扫日志的 mtime、停用记录
所有入库文本先脱敏:sk-…、Bearer …、apiKey|token|secret|password=。
日志来源:~/Library/Logs/DeepSeek Harness/crash-*-host.log、crash-*-web-boot.log、$DSH_HOME/logs/startup-*.log。
一句话
崩溃不可避免,但同一句话崩两次是可以避免的。 这个插件做的事,就是把「这次是怎么崩的」变成「下次崩不了」——代价只是你愿意花一分钟跑一次 doctor。
*参考:GitHub regrevia/dsh-lifeguard(MIT,1 star),2026-11-04 更新。*
相关阅读
- DSH 越用越卡?加个按钮不重启换插件 —— 不重启换插件
- 大肥鱼部署避坑:12 个新手最容易踩的坑 —— 部署阶段就能避开的坑
- dsh-lite-memory:给 agent 装一个不常驻的记忆 —— 记忆省着用