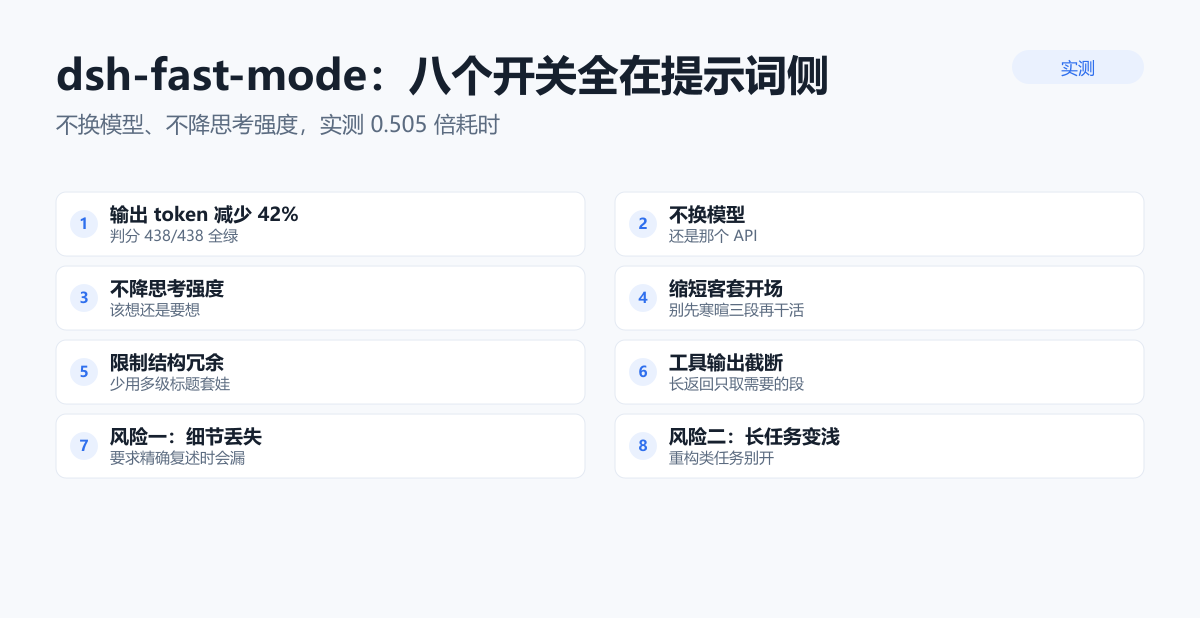
先看数字
| 指标 | 结果 |
|---|---|
| 耗时 | 最快 0.505×(不到原来一半) |
| 输出 token | −42% |
| 判分 | 438/438 全绿 |
「判分全绿」比前两行重要得多。省 token 不难,难的是省完还能把活干对。速度提升如果把正确率拉下来,那是负优化。
它的做法是纯提示词侧的:不加请求参数、不改模型、不改完成判定。换句话说,模型还是那个模型,思考强度还是那个强度,变的只是「它被要求怎么说话」。
八个开关分别管什么
前两个管输出,最后一个管上下文体积,中间五个管「怎么走」。
| # | 开关 | 原理 | 默认 |
|---|---|---|---|
| 1 | 精简输出 | 不预告调用、不复述结果、不写进度,最终答案不缩水 | 开 |
| 2 | 步数上限 | 硬上限,到点先汇报现状,不截断任务 | 不限 |
| 3 | 开局附文件清单 | 开局把工作目录交给模型,省掉先跑一遍 ls/find |
关 |
| 4 | 批量读文件 | 互不依赖的读取合成一批发出,少几个来回 | 关 |
| 5 | 截短工具输出 | 只留头尾和报错行,长输出不再整段进上下文 | 关 |
| 6 | 不确定先查证 | 拿不准就读一次;省的是猜错后的重来 | 开(标准/激进) |
| 7 | 先执行后解释 | 动手前最多一行计划;思考过 4000 字符时提醒「按证据动手」 | 开(标准/激进) |
| 8 | 重复时换方法 | 同一调用重发、或连续三次结果一样时,提醒换条路 | 开(标准/激进) |
第 1 个:精简输出
这是省 token 的主力。「不预告调用、不复述结果、不写进度」——agent 有个通病,喜欢在动手前先宣布「我现在要去读一下这个文件」,读完再总结「我刚才读了,发现……」,最后再写一遍结论。同一件事说了三遍。
关掉这些,最终答案并不缩水。少的是过程叙述,不是结论。
第 2 个:步数上限
注意它的措辞:到点先汇报现状,不截断任务。这跟「跑满 N 步就强行停」是两回事。前者是「还有 20 步没做,我先告诉你做到哪了」,后者是「做到一半被砍断,什么都不说」。
默认不限,因为很多人真需要跑上百步。
第 3 个:开局附文件清单
省掉的是最开头那一轮 ls 和 find。项目结构直接在开局给它,不用先摸一遍。默认关,因为清单本身要占 token——大仓库里未必划算。
第 4 个:批量读文件
互不依赖的读取合成一批发出。五个文件分五次读,就是五个来回;一次发五个,就是一个来回。省的是往返次数,也就是墙钟时间。
第 5 个:截短工具输出
这是唯一会改变模型所见证据的开关,所以默认关,且关掉就是原文。
只留头尾和报错行。好处明显:一个 3000 行的日志不再整段进上下文。风险也明显:被截掉的中间部分可能正好有线索。
作者的处理方式我认同——默认关,让你自己决定。省 token 和看得全,本质上是冲突的,不该默认替用户做选择。
第 6、7、8 个:三条「怎么走」的思考开关
这三条经历过一次反复,值得说。
它们 1.7.0 起引入,1.7.26 曾收回,1.7.29 依据 15 对实测结果放回,随标准/激进档一起载入,保守档仍全关。
放回的实测数据:叠在精简输出之上是 0.526×,15 对里有 14 对更快。
「先执行后解释」的细节很讲究:动手前最多一行计划;如果模型已经思考超过 4000 字符还没动手,就提醒它「按证据动手」。这条针对的是一个真实病症——想得太多,做得太少。
「重复时换方法」盯的是另一种病症:同一个工具调用重发,或者连续三次结果一样。这时候它不劝你「再试一次」,而是提醒「换条路」。agent 最常见的浪费就是在一个死胡同里反复撞。
档位:只用路由真的声明过的
有个细节容易被忽略,但对自建网关的人很重要:
只使用当前路由真正声明过的档位,官方 API 与自建网关都支持。
意思是它不会硬塞一个模型不认识的参数。你接的是官方 API 还是自己的网关,它先看对方声明支持什么,再决定用哪一档。这条设计避免了「本地测试好好的,换成第三方网关就报错」。
输出预算:outputBudget
1.5.0 加的一个机制,默认 0(关闭)。
它按真实 usage.outputTokens 触发,每轮最多一次。不是估算,是读实际用量。触发之后会下一道输出预算指令。
这个默认值是合理的。按 token 预算硬性限流,容易把该说的结论也掐掉;默认关,需要的人自己开。
1.5.0 的重基线
版本说明里有一行:1.5.0 rebaseline: 9 families, 54 complete units, hidden-test gated。
翻成人话:9 个任务族、54 个完整单元、用隐藏测试做门禁。后来又加了 codebase 族(18 条隐藏断言,seed 6/18 红,默认臂 0.84× 墙钟)。
为什么要说这个?因为「我快了 2 倍」这种话,如果没有固定的评测集,是没法验证的。作者把自己的评测基线、隐藏测试、红灯比例都摊出来,这才让 0.505× 这个数字有分量。
怎么用
八个开关在面板里点,组合自由。不想折腾就选一个档:
- 保守:三条思考开关全关,只留精简输出
- 标准:三条思考开关打开(推荐起点)
- 激进:全开
我的建议是先只开精简输出,用一天。看看回答是不是还够用。如果够,再往标准档走。
一次全开,出了问题你分不清是哪个开关的责任。
一句话
它省的不是模型能力,是模型的话痨。 同一件事说三遍的毛病改掉了,速度快一倍是自然结果,不是压榨出来的。
*参考:GitHub regrevia/dsh-fast-mode(MIT,9 stars),1.7.14 → 1.7.29,2026-11-05 更新。*
相关阅读
- 养大肥鱼到底烧多少钱?一份真实账单和 8 个省钱技巧 —— 这一下省多少钱
- DSH 越用越卡?加个按钮不重启换插件 —— 卡顿还有另一个解法
- DSH 插件怎么选?大肥鱼必装的 8 个插件 —— 其他值得装的插件