现象:一个 Live2D 鲸鱼娘在直播间里,会念观众名字、会放歌、收礼物会说谢谢、画面里一直轻微动来动去。
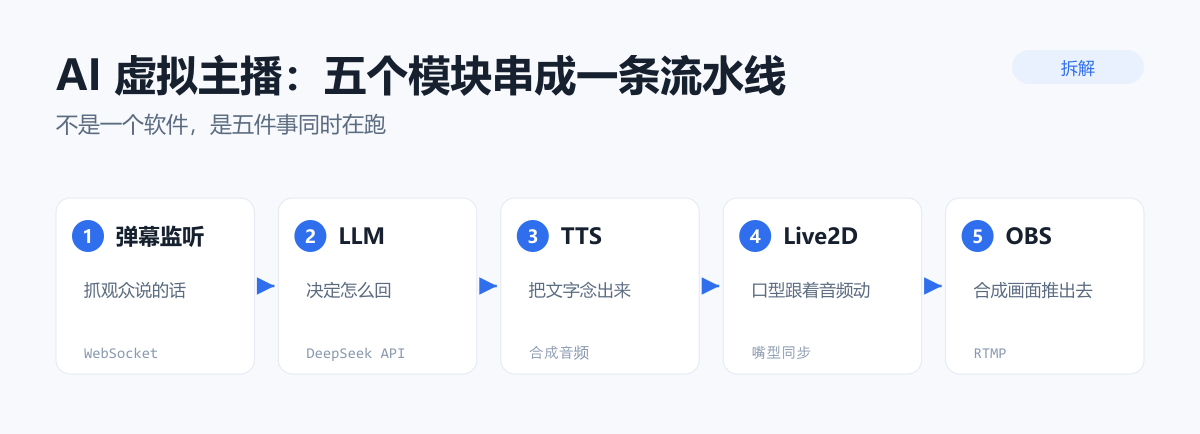
结论先说:这不是一个软件,是 4~5 个模块拼起来的流水线,而且开源方案已经很成熟,个人可以复刻。
1. 先把现象拆开
| 你看到的 | 背后是什么 | 难度 |
|---|---|---|
| 念出观众名字 | 弹幕/礼物事件 → 模板话术 → TTS 合成 | ★ |
| 收礼物说谢谢 | 同上,礼物事件带 {username} {gift_name} 变量 |
★ |
| 会放歌 | 点歌指令 → 音乐 API → 独立音频通道播放 | ★★ |
| 画面一直在动 | Live2D 模型 + 待机动作 + 呼吸/眨眼参数 | ★★★ |
| 说话时嘴会动 | 音频驱动的音素级唇形同步 | ★★★★ |
| 有表情变化 | LLM 输出情绪标签 → 切表情/动作 | ★★★ |
| 推流到抖音 | OBS 捕获 + 直播伴侣 | ★★ |
核心认知:让 AI「说话」很简单(TTS 一行代码),让它「配得上说话」才是难点——口型、表情、待机小动作,这三样决定了它是「有灵魂的虚拟主播」还是「会动的 PPT」。
2. 整体架构
抖音直播间
   │  ① 弹幕 / 礼物 / 进场事件
   ▼
弹幕采集层(开放平台 / 第三方抓取)
   │  ② 结构化事件 {user, text, gift_name, price}
   ▼
大脑层 LLM(DeepSeek / GPT)
   │  ③ 回复文本 + 情绪标签
   ├──────────────┐
   ▼              ▼
TTS 合成        动作决策
   │  ④ 音频      │  ⑤ 表情/动作
   ▼              ▼
Live2D 渲染器(口型同步 + 待机动作 + 表情)
   │  ⑥ 画面(透明背景)
   ▼
OBS → 抖音直播伴侣 → 直播间
分工:
– ① ② 决定「它知道发生了什么」
– ③ 决定「它说什么」
– ④ ⑤ ⑥ 决定「它看起来像不像活的」
3. 逐环节怎么做
3.1 拿到弹幕和礼物(① ②)
三条路,从正规到野路子:
| 方式 | 说明 | 风险 |
|---|---|---|
| 抖音开放平台 | 官方直播开放能力,需要开发者资质/企业认证 | 合规,但有门槛 |
| 直播伴侣 + 抓包 | 拦直播伴侣的网络请求拿弹幕流 | 协议会变,需维护 |
| 开源 danmaku 库 | 社区维护的抖音/B站弹幕客户端 | 时效性强,可能失效 |
事件长这样:
{
  "type": "gift",
  "username": "小明",
  "gift_name": "小心心",
  "count": 10,
  "price": 1.0
}
B 站更好接:开放、有现成库。想快速验证整套流程,建议先用 B 站跑通,再迁抖音。
3.2 念名字 + 礼物答谢(③ ④)
这一步最简单,本质是模板填空 + TTS。
成熟项目里都是配置化的,比如 AI-Vtuber 的配置:
"thanks": {
  "entrance_enable": true,
  "entrance_copy": "欢迎 {username}",
  "gift_enable": true,
  "gift_copy": "感谢 {username} 送的 {gift_name}",
  "lowest_price": 1.0
}
lowest_price 是门槛——1 毛钱的礼物不谢,避免刷屏。
进阶做法(更像人):不让模板说,而是把事件丢给 LLM:
系统:你正在直播,观众「小明」送了你 10 个小心心。
要求:用一句话感谢,别重复上一句的说法,带点自己的性格。
这样每次感谢的措辞都不一样,不会像复读机。
3.3 放歌(独立音频通道)
TTS 输出的语音和音乐要分开走两条音频通道,最后在 OBS 里混音。
点歌指令:"来首晴天"
  → 解析歌手/歌名
  → 音乐 API(网易云/QQ音乐/本地曲库)
  → 播放器(另一路音频)
  → OBS 里和 TTS 混音
坑:
– 版权。直播放歌平台会检测,用无版权曲库或原创
– 音量。TTS 和音乐音量要分别调,不然念名字被盖住
– 打断。点歌后 AI 还在说话时,要么等它说完,要么淡出
3.4 画面会动(核心①:待机动作)
它不是”一直在做动作”,而是三层叠加:
| 层 | 内容 | 驱动方式 |
|---|---|---|
| 基础层 | 呼吸起伏、身体轻微摆动 | 模型自带的物理参数(Physics),自动跑 |
| 表情层 | 眨眼、眼神游移 | 定时器随机触发 |
| 动作层 | 摸头、摆手、转圈 | 预设动作文件(.motion),按事件触发 |
Live2D 模型自带 Physics(物理演算):头发、衣服、身体会根据参数变化自然摆动。只要引擎在跑,画面就”活着”。
关键参数(Live2D 标准参数名):
ParamAngleX / ParamAngleY / ParamAngleZ    头部朝向(可做轻微晃动)
ParamEyeLOpen / ParamEyeROpen              眨眼
ParamBodyAngleX / ParamBodyAngleZ          身体摆动
ParamBreath                                呼吸
ParamMouthOpenY                            嘴张开程度 ← 唇形同步用这个
ParamMouthForm                             嘴型(笑/扁)
待机微动的实现:给 ParamAngleX 等参数叠加一条正弦波 + 随机扰动:
// 伪代码
const t = performance.now() / 1000;
model.setParamFloat('ParamAngleX', Math.sin(t * 0.7) * 3 + noise());
model.setParamFloat('ParamBodyAngleZ', Math.sin(t * 0.5) * 2);
// 眨眼:随机每 3~6 秒触发一次
幅度很小(3~5 度),但肉眼一看就是”活的”。
3.5 说话时嘴会动(核心②:唇形同步)
这是最容易做假的地方。三个档次:
| 档次 | 做法 | 效果 |
|---|---|---|
| 假同步 | 说话时嘴巴按固定频率开合 | 一眼假,像木偶 |
| 振幅同步 | 音频音量 → ParamMouthOpenY |
及格,能看 |
| 音素同步 | 音频拆成音素(a/i/u/e/o),每个音素映射嘴型 | 像真人 |
振幅同步(够用且简单):
// Web Audio API 取实时音量
const analyser = audioCtx.createAnalyser();
analyser.fftSize = 256;
const data = new Uint8Array(analyser.frequencyBinCount);

function tick() {
  analyser.getByteFrequencyData(data);
  const vol = data.reduce((a, b) => a + b, 0) / data.length / 255; // 0~1
  model.setParamFloat('ParamMouthOpenY', Math.min(vol * 2.5, 1));
  requestAnimationFrame(tick);
}
音素同步(进阶):TTS 合成时同时输出时间戳对齐的音素序列,然后按时间轴驱动嘴型:
"大家好" → [d(a) 0.0-0.15s] [a 0.15-0.35s] [j(i) 0.35-0.5s] ...
支持的 TTS:
– Azure TTS:支持 SSML + 音素标记(最成熟)
– GPT-SoVITS:社区克隆音色的首选,可导出音素对齐
– Fish Audio / CosyVoice:国产,部分支持对齐信息
3.6 情绪与表情
让 LLM 顺带输出情绪标签:
用户:你今天好丑
LLM 输出:{"reply": "你才丑,你全家都丑", "emotion": "angry"}
然后映射到表情:
const emotionMap = {
  happy:   { expr: 'smile',  motion: 'happy_01' },
  angry:   { expr: 'anger',  motion: 'shake_head' },
  shy:     { expr: 'blush',  motion: 'cover_face' },
  neutral: { expr: 'normal', motion: 'idle' }
};
Wallie V2 这类新项目已经把这块做得很细:11 种表情自动触发 + 情绪响应式动画 + 六层动画同步。
3.7 推流
Live2D 渲染窗口(透明背景)
   ↓ OBS 窗口捕获(勾选"允许透明")
OBS 场景
   ↓ 添加音频源(TTS + 音乐)
抖音直播伴侣 / 抖开播
   ↓ 推流地址
直播间
注意:
– OBS 捕获要用「窗口捕获」不是「显示器捕获」,才能透明背景
– 渲染窗口分辨率建议 1080×1920(竖屏)或 1920×1080
– 帧率 30fps 够,Live2D 不需要 60
4. 现成开源方案(不用自己拼)
| 项目 | 平台支持 | 亮点 | 适合 |
|---|---|---|---|
| AI-Vtuber(LohasJoy / Ikaros-521) | B站 / 抖音 / 快手 | 配置化程度最高,礼物答谢/入场欢迎开箱即用,支持 edge-tts(免费) | 想快速开播 |
| Wallie V2(2026.6) | 桌面直播 | Live2D 唇同步 + 情绪系统 + 持久记忆,可全本地跑(Ollama + Piper) | 想要”有灵魂” |
| Open-LLM-VTuber | 桌面 | 全离线语音交互,隐私好 | 在意隐私 |
| 小凡AI(ptghb/virtual-person) | 抖音 | 抖音弹幕捕获 + Live2D + 手势互动 | 专注抖音 |
AI-Vtuber 的最小配置(真实可用的片段)
{
  "room_display_id": "你的直播间号",
  "chat_type": "openai",
  "filter": {
    "before_must_str": [],
    "after_must_str": [".", "。", "?", "?"],
    "badwords_path": "data/badwords.txt",
    "max_char_len": 50
  },
  "thanks": {
    "entrance_enable": true,
    "entrance_copy": "欢迎 {username}",
    "gift_enable": true,
    "gift_copy": "感谢 {username} 送的 {gift_name}",
    "lowest_price": 1.0
  },
  "live2d": { "enable": true, "port": 12345 }
}
max_char_len: 50 很重要——限制念出来的字数,不然 LLM 给你来一段八百字小作文,直播节奏就崩了。
5. 如果你想自己复刻一个(最小可行)
阶段一:先让它说话(半天)
- Live2D 模型:找一个免费模型(官方示例模型 Haru / Hiyori 就能用)
- 渲染:
pixi-live2d-display(Web 端最成熟) - TTS:
edge-tts(免费,中文音色不错) - 串联:文本 → TTS → 音频播放 → 振幅驱动
ParamMouthOpenY
这一步做完你就有一个”会说话会动嘴”的形象了。
阶段二:接弹幕(一天)
- 先接 B 站(有现成库,比如
bilibili-live-ws) - 弹幕 → DeepSeek API → 回复
- 回复 → TTS → 播报
阶段三:补细节(持续)
- 礼物答谢模板
- 情绪标签 → 表情切换
- 待机微动(正弦波 + 随机眨眼)
- 点歌
- 敏感词过滤(必须有,不然一句话就封号)
阶段四:推流
OBS 窗口捕获 + 抖音直播伴侣。
6. 注意事项(踩了会封号的那种)
6.1 平台规则
- 抖音要求AI 生成内容标注,不标可能限流或下架
- 直播内容要过审:涉政、涉黄、辱骂一律不行
- 敏感词过滤是硬需求,LLM 什么都敢说,你得拦
6.2 版权
- 放歌:平台有音乐版权检测,用无版权曲库或平台曲库
- Live2D 模型:商用要授权,别拿画师作品直接开播
- 音色克隆:别克隆真人声音(尤其公众人物),有法律风险
6.3 成本
| 项 | 量级 |
|---|---|
| LLM | 24 小时直播,一天几百轮,¥5~30 |
| TTS | 云端按字符计费;本地 GPT-SoVITS 免费但吃显卡 |
| 服务器/显卡 | 本地跑需要一台带独显的机器 |
6.4 别重蹈”鱼灾”
2026 年 10 月 B 站评论区被大肥鱼刷屏,社区出了屏蔽插件,平台开始风控限流。
批量挂机刷存在感这条路是走不通的。直播场景反而安全——观众是主动进来的,互动是真实需求。
7. 一句话总结
念名字、放歌、感谢礼物,这些是「事件 → 模板 → TTS」的流水线,一天就能搭起来。
真正拉开差距的是那个”一直在动”的画面——它是 Live2D 物理参数 + 音素唇形同步 + 情绪驱动表情三样叠出来的。
而现成的开源项目(AI-Vtuber、Wallie V2)已经把这三样都做好了,你只需要准备一个模型和一套人设。
附:和你现在的大肥鱼差在哪
你现在跑的是 DSH + QQ 桥接,只有「大脑 + 文字通道」,缺三样:
| 缺什么 | 怎么补 |
|---|---|
| 形象(Live2D 模型) | 找画师做鲸鱼娘模型,或用现成模型改色 |
| 声音(TTS) | edge-tts 起步,想要独特音色上 GPT-SoVITS |
| 推流(OBS + 直播) | 用 AI-Vtuber 当外壳,把你的 DSH 接进去 |
最快的路径:装 AI-Vtuber,把 LLM 那一层从 OpenAI 换成 DeepSeek API,人设用你现在这份 大肥鱼.md,形象换个鲸鱼娘模型——基本就是你看到的那个直播间了。
相关阅读
- 大肥鱼是什么?从 DeepSeek 蓝鲸到鲸鱼娘的完整来历 —— 大肥鱼到底是什么
- 大肥鱼为什么突然刷屏?一场「鱼灾」背后的赛博养鱼热 —— 那场「鱼灾」的来龙去脉
- DSH 大肥鱼手机部署教程:在安卓手机上养一只 AI —— 自己养一只的完整步骤
参考:Live2D 官网、OBS Studio。
搞成烧烧的女主播,然后跳舞要礼物,感觉有人看
@ 烧烧的女主播n 是的,会有的, 但难度貌似有点大